


Web Audio APIでAIイラストをリップシンクさせてみた
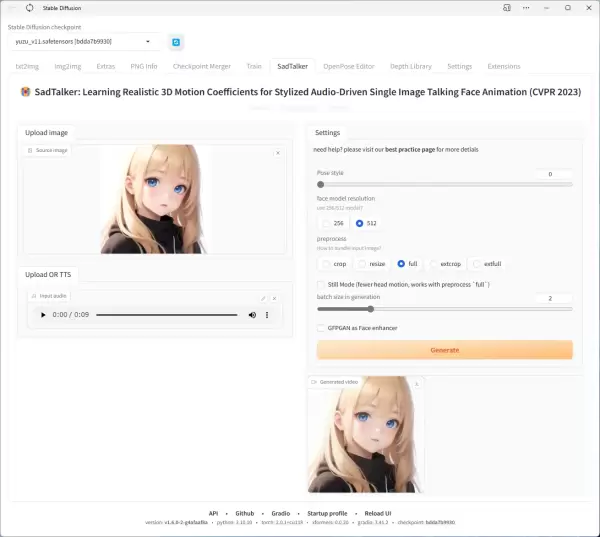
昨日の「AIイラストをSadTalkerで口パクさせてみた」で、そのリップシンク技術に感銘を受けたため、少しでも近いことが出来ないものか?と丸1日悩んでいました。
ボツ案
おそらく一番てっとり早くて、正攻法なのはLive2Dを使うこと。音素解析も出来るようなので、母音の形ごとに口パーツを用意したプロ並みのリップシンクが実現可能そうです。
うーん、でもなぁ。Live2Dってフリー版だと解像度とかに制限があるのがちょっと気になるんですよね。無料で使わせて頂けるのだからそのくらい我慢しろって話ですが、いざ本気で使いたくなった場合、サブスクしかないのが気になるんです。月額2,288円程度とはいえ、うーんうーん、最終手段かなー。
次に気になったのが、DaVinci Resolveという動画編集ソフトのプラグインである Suck Less Audio を使った波形解析による口パク。
音素ほど自然ではないけれど、音量による分岐が可能なので、閉口/開口の二択だけではなく、中間も出来るから、悪くない選択肢に思えました。
そして思いついたら即実践、ということでDaVinci Resolveのインストール、reactor導入、 Suck Less Audio導入、Fusion設定、とやってみたのですが…………………面倒くさいわwww
おそらく DaVinci Resolveの操作自体に慣れていないせいだと思いますが、いちいち操作に手間がかかって、これを毎回やるの?と思うとウンザリしてしまいました。
本命:Web Audio API
どうにか、量産型オカズのために、「AI絵を生成する→口パク差分作る→音声作る→両方ほおりこんだら完成」くらいお気楽お手軽な手段を確立したい。
そんなワガママな欲求を胸にインターネットの海を泳いでいたら、こんな記事を見つけました。
Web Audio APIでリップシンク(もどき)を作ってみた話
https://qiita.com/iroha71/items/2867f61f459a333ffeb3
…す、すげえぇぇ!!
3年も前の記事なんだけど、その時点で既にJavaScriptとWeb Audio APIによるリップシンク実現してる人おった。
ありがたいことにソースも公開してくださっていたので、丸パk…ごほん…参考にさせて頂くことにしました。
ソースコードの大半は理解できましたが、記事でピックアップされているスペクトラム解析の部分が全くわからんwww
いやわかる。やりたいことはわかる。
スマホの加速度センサーを読み取って、スマホ振ったパワーに応じてアンアン喘ぐおバカなアプリを作ったこともあるぼくです。
あれは移動量を単位時間ごとに集計して、パワーとして換算していましたが、たぶん音でも同じことをやっているのでしょう。
正確なところはよくわかりませんが、よくわからなくてもコードは動くので、理解するのはいったん諦めて、そのままありがたく実装させて頂きました。
Web Audio APIでAIイラストをリップシンクさせてみた
音声入替:
音声:VOICEVOX:中国うさぎ様
はい!
ベース絵

Prompt
highres,4k,8k,extreamely detailed eyes
,1girl,twintail hair,maid dress
,flat chest,(droopy eyes)
,skirt lift,white panties
,simple white background <lora:jyojipan_ver2_NP:1>
Negative prompt: (worst quality, low quality:1.2),monochrome,lowres,bad anatomy,watermark, text, sketch,missing finger,extra finger
Steps: 30, Sampler: Euler a, CFG scale: 7, Seed: 2313667987, Size: 512x768, Model hash: 6df59b69e0, Model: kaywaii_v65, Denoising strength: 0.75, Clip skip: 2, Mask blur: 4, Lora hashes: "jyojipan_ver2_NP: 38ff41360337", Version: v1.6.0-2-g4afaaf8a
差分


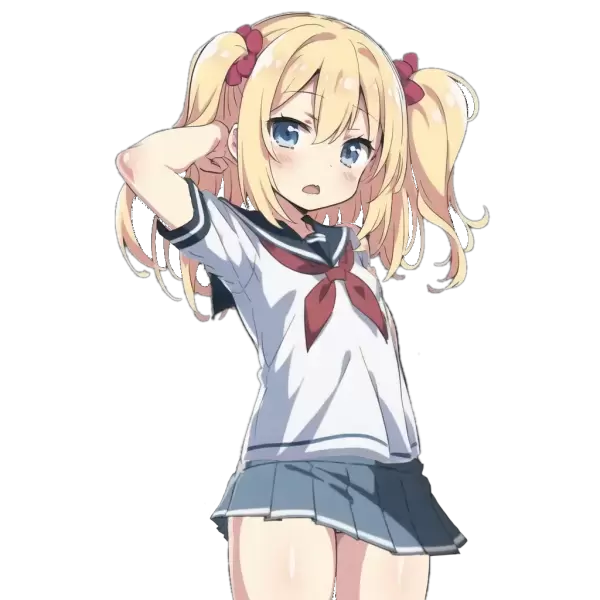
最近、XP-Pen Deco01というペンタブレット買ったので、試しにペンタブで切り抜き処理してみました。マウスと比べて格段に楽で早い。絵は描けないし、描けるようになる未来も見えないけれど、画像加工に活用していこうと思っています。
まとめ
そういえば以前、VRChatにハマっていた頃、3Dアバターに母音時の口の形を登録する箇所があり、へぇ細かいんだなぁ、などと軽く流していましたが、よく考えたらすげーことですよねぇ。こっちはリアルタイムでしゃべってるわけで、その音声解析して母音の判定してるってことでしょ。
たぶん、そっち方面に詳しい方なら同じくWeb Audio API使って音素を分けたりできるのかもですが… 個人的にはこの周波数解析だけで十分かなぁ。なにしろ口の形をコレ1個で済ませられるのが良い!

内部で解析している音量?密度?音圧?らしきものを3段階にわけて、口の縦サイズをリアルタイム変形しているので、口の元画像は1つで良いのです。
これなら量産型オカズを作りたい、というぼくの要望にもぴったり。
問題は動画に反映させようと思ったら面倒、というくらいかなぁ。まぁそのあたりは、たとえばブラウザ上でグリーンバックで再生できるようにして、後で合成しても良いか。
専門外のため周波数の部分はよくわかりませんでしたが、楽しいプログラミングが出来ました。Qiitaに情報開示してくれたいろは様に感謝。